
大家好!歡迎來到「Build on Google AI」工程挑戰的第 11 天。
在昨天的實戰中,我們的代理人化身為網路爬蟲,成功抓取了外部的 AI 趨勢。但在「研發與工程創新」的真實戰場上,我們面臨的最大敵人往往不是「沒有數據」,而是「數據太髒」。
舉個最常見的例子:當我們在籌備技術大會時,講者透過 Email 或 Luma 備註欄位傳來的資料可能是這樣的:「嗨我是 Kevin,在 APMIC 當TPM,這次想分享 GenAI 實戰。對了我吃素,另外講者介紹幫我寫喜歡喝半糖少冰的烏龍奶茶,謝謝!」
面對這種口語化、毫無規則可言的非結構化情報,傳統的 Regex (正規表達式) 根本無用武之地。今天,我們將利用 Google ADK 建立一個專職的資料清洗代理人,讓 Gemini 成為我們最可靠的資料解析器 (Parser)!
第一步:AI 數據清洗的工程思維
在微服務或 Agent 架構中,我們不應該讓同一個代理人同時負責「專案管理」、「網路爬蟲」又兼做「資料清理」。這違反了單一職責原則 (Single Responsibility Principle)。
為此,我們需要定義一個全新的 ADK 代理人,它的唯一任務就是:接收髒數據,吐出結構化的 JSON。
第二步:定義資料清洗代理人打開我們的 agent.py,我們將使用 Agent 類別與 gemini-flash-latest 模型來建立這個專屬的資料處理節點。 這裡的關鍵在於 instruction (系統提示詞) 的設計。我們必須透過提示詞,嚴格限制模型的輸出格式。
from google.adk.agents.llm_agent import Agent

# 定義嚴格的資料清洗提示詞
data_cleaner_instruction = """
你是一個後端系統的專業資料解析器 (Data Parser)。
你的唯一任務是從使用者提供的非結構化文字中,萃取出關鍵資訊,並「嚴格且僅」以 JSON 格式輸出。
絕對不要包含任何 Markdown 標記(如 ```json)或額外的問候語。

需要萃取的 JSON 欄位與型態定義如下:
{
    "name": "字串,講者姓名",
    "company": "字串,任職公司,若無則填 null",
    "topic": "字串,演講主題",
    "dietary_preference": "字串,如 素食/葷食,若無提及填 null",
    "special_notes": "字串,其他特殊需求或備註"
}
"""

# 建立資料清洗代理人
data_cleaner_agent = Agent(
    model='gemini-flash-latest',
    name='data_cleaner_agent',
    description="Extracts and formats unstructured text into strict JSON data.",
    instruction=data_cleaner_instruction,
)
(程式碼說明:我們建立了一個名為 data_cleaner_agent 的代理人,並將精心設計的提示詞賦予了 instruction 參數,確保它能勝任解析任務。)
第三步:見證亂碼變黃金
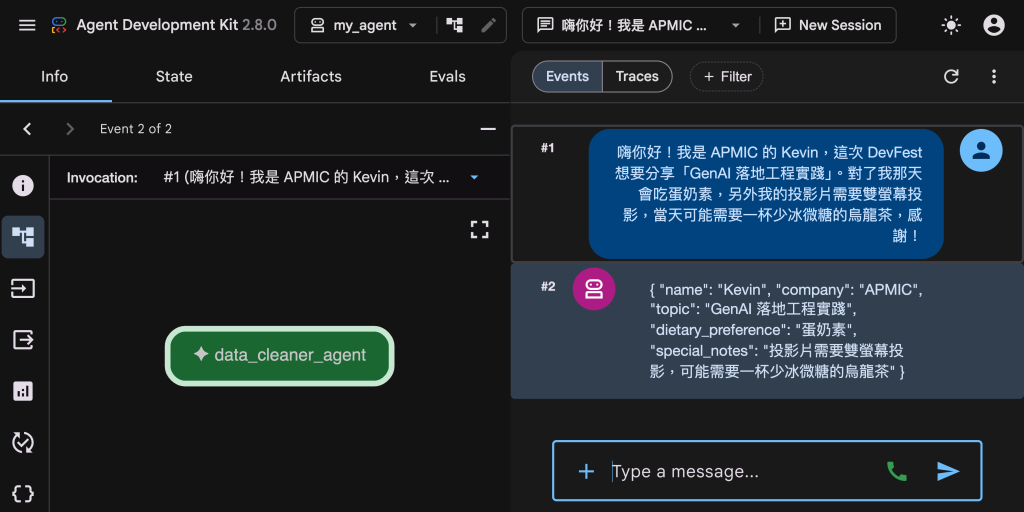
現在,當我們將前面那段充滿口語與冗詞贅字的講者 Email 餵給這個 data_cleaner_agent 時,它會穩定且精準地吐出以下結果:
{ "name": "Kevin",
  "company": "APMIC",
  "topic": "GenAI 落地工程實踐",
  "dietary_preference": "蛋奶素",
  "special_notes": "投影片需要雙螢幕投影,可能需要一杯少冰微糖的烏龍茶" }
這在工程實踐上具有巨大意義!一旦資料變成了標準的 JSON 字典 (Dictionary),你的 Python 程式碼就能輕鬆地使用 json.loads() 將其解析,並進一步寫入資料庫,或是透過 API 自動建立票卷與訂便當系統的清單。
小結
今天,我們利用 Gemini 極強的語意理解能力,結合 ADK 代理人的 instruction 機制,完美解決了傳統軟體工程中最頭痛的「髒數據解析」難題。這大幅提升了系統在面對真實世界複雜輸入時的容錯率與穩定度。


 iThome鐵人賽
 看影片追技術